 zxell.ai
review26: S ベースライン完走 — test PPL en 22 / de 29 / fr 22 / ja 132、4 言語の生成サンプル、フェーズ 1 の完了判定とフェーズ 2 へ
作成日: 2026-10-11 対象: 10/10 に起動した S(29.1M)ベースライン(シャード v4、90,000 ステップ)の完走報告。test 評価と生成サンプルはお客様に 3060 で実行していただき、結果をそのまま引用する。
要旨
- 完走: 90,000 ステップ / 29.5 億トークン / 21 時間 24 分(見積り 21 時間)。学習 loss は 10.78 → 3.2
- 成績(初見データ test、言語別パープレキシティ): en 22.1 / fr 21.9 / de 29.1 / ja 132.0、全体 33.0。val とほぼ同じ値で過学習なし
- 生成: en / de / fr は文法的に整ったニュース調の文を出す。ja は英語混じりで崩れる — 数値(ja 132)と目視が一致
- フェーズ 1 の完了判定: 達成(判断ポイント「S がまともな文を生成し、評価が自動で回ること」は en/de/fr で満たし、評価は自動化済み)。ただし日本語は「弱点」として定量的に確定 — フェーズ 2 以降の設計課題に(5 章)
- この結果が 分散学習の比較対象(物差し)になる。成功基準「劣化 10% 以内」の具体的な閾値を 6 章に
1. 完走ログ
{"step": 89960, "loss": 3.3066, "lr": 6.0000279611533744e-05, "grad_norm": 1.427, "tok_per_s": 38298, "elapsed_s": 76970}
{"step": 89970, "loss": 3.1114, "lr": 6.000015984931814e-05, "grad_norm": 1.452, "tok_per_s": 38298, "elapsed_s": 76979}
{"step": 89980, "loss": 3.2312, "lr": 6.000007335437363e-05, "grad_norm": 1.45, "tok_per_s": 38298, "elapsed_s": 76987}
{"step": 89990, "loss": 3.2589, "lr": 6.0000020126710894e-05, "grad_norm": 1.577, "tok_per_s": 38298, "elapsed_s": 76995}
{"step": 90000, "loss": 3.1602, "lr": 6.000000016633646e-05, "grad_norm": 1.516, "tok_per_s": 38298, "elapsed_s": 77004}
{"step": 90000, "eval": "val_full", "all": 32.33, "en": 20.18, "de": 28.88, "fr": 21.8, "ja": 132.2}
done: 90000 steps, 2949.12M tokens, 77050s| 項目 | 値 |
|---|---|
| モデル | S: 6 層 / d_model 384 / 6 head / ctx 1024、29.1M パラメータ(うち埋め込み 18.4M) |
| データ | シャード v4、train 5.51B トークンのうち 2.95B を 1 回ずつ(0.53 エポック) |
| 学習 | batch 32 × 1024、AdamW、lr 6e-4 → 6e-5(cosine)、bf16、RTX 3060 |
| 所要 | 77,050 秒 = 21 時間 24 分、平均 38,300 トークン/秒 |
| 終盤の学習 loss | 3.1〜3.3(PPL ≈ 24) |
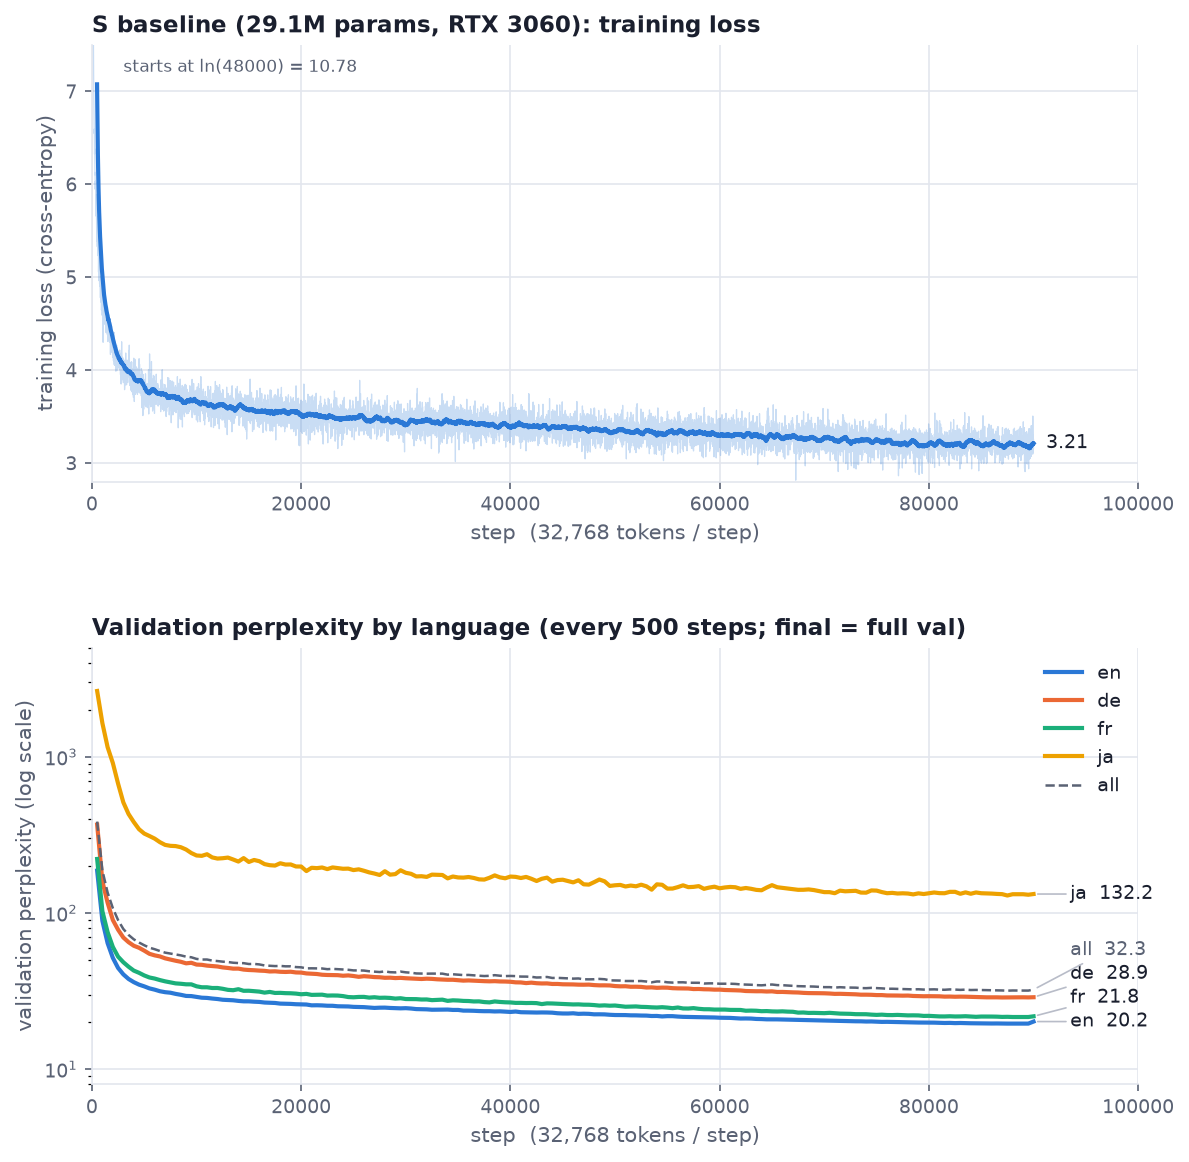
(上: 学習 loss。薄線が生値、太線が 50 点移動平均。下: 500 ステップごとの val PPL、対数軸。最終点は val 全量)
val PPL の推移(抜粋):
{'step': 500,   'all': 384.59, 'en': 186.68, 'de': 367.7,  'fr': 221.68, 'ja': 2635.84}
{'step': 5000,  'all': 62.13,  'en': 33.9,   'de': 57.38,  'fr': 39.82,  'ja': 322.37}
{'step': 20000, 'all': 44.88,  'en': 26.01,  'de': 41.54,  'fr': 30.17,  'ja': 198.28}
{'step': 45000, 'all': 38.31,  'en': 22.73,  'de': 34.95,  'fr': 26.12,  'ja': 163.26}
{'step': 70000, 'all': 33.51,  'en': 20.48,  'de': 30.61,  'fr': 22.84,  'ja': 135.95}
{'step': 90000, 'all': 32.33,  'en': 20.18,  'de': 28.88,  'fr': 21.8,   'ja': 132.2}   ← val 全量
最初の 5,000 ステップで大半が決まり、その後は緩やかに改善し続けている(終盤でも下がり止まっていない = まだ学習の余地がある)。
2. test の言語別パープレキシティ(最終成績)
{
  "ckpt": "runs/S_baseline/ckpt_final.pt",
  "step": 90000,
  "split": "test",
  "ctx": 1024,
  "result": {
    "all": {"ppl": 33.03639638530772, "tokens": 15790080},
    "en":  {"ppl": 22.0779424901173,  "tokens": 4947836},
    "de":  {"ppl": 29.058653769872706, "tokens": 3995807},
    "fr":  {"ppl": 21.946490973796574, "tokens": 3888980},
    "ja":  {"ppl": 132.03231031373687, "tokens": 2957457}
  }
}| 言語 | val | test | 学習データ中の比率(トークン) |
|---|---|---|---|
| en | 20.18 | 22.08 | 61.6% |
| fr | 21.80 | 21.95 | 11.0% |
| de | 28.88 | 29.06 | 23.9% |
| ja | 132.20 | 132.03 | 3.5% |
| 全体 | 32.33 | 33.04 | — |
- val と test がほぼ同じ = モデルは val に合わせ込まれておらず、初見データへの汎化が成立している
- en が fr より僅かに悪化(20.2 → 22.1)したのは、en の test が「収集最終 4 日間」というピンポイントな期間(review21 5 章の懸念)で、その週のトピックの影響と見ている。許容範囲
- fr が de より良い(21.9 vs 29.1)のはデータ量の順(de 24% > fr 11%)に反する。fr はトークナイザの圧縮効率が低い(3.80 字/トークン vs de 4.18)= 1 トークンが短く予測しやすい、という効果と、ドイツ語の複合語・格変化の難しさの両方が効いていると考えられる。言語間の PPL 比較はトークン化の粒度に依存するので、言語間の優劣ではなく、各言語の時間変化・方式間比較に使うのが正しい使い方
- ja 132 は他の 5〜6 倍。データが 3.5% で、かつ 1.95 字/トークンと予測単位が細かい。一方で 500 → 90,000 ステップで 2,636 → 132(1/20)と最も大きく改善しており、「少ないなりに学習は効いている」
3. 生成サンプル(そのまま引用)
$ python sample.py runs/S_baseline/ckpt_final.pt --sp ~/sp_bpe_48k.model --prompt "The central bank" --tokens 80 --n 2
--- sample 0 (step 90000) ---
The central bank will produce 10% of a percentage point of GDP growth in 2020. The growth rate for the U.S. economy is 6.7% and China is 6.5% below the pre-pandemic level of 7.2%. The Japanese economy is forecast to post growth of 7.2% in 2020.
--- sample 1 (step 90000) ---
The central bank is the largest economy in the world, and the biggest economy is the poorest. The greenback will last for one-third of GDP, and a third of the economy, and the government will have to implement some government reforms. The Chinese economy’s population will shrink, thanks to the weakening domestic economy, and have grown quickly in recent years, according to the International Monetary Fund
$ python sample.py ... --prompt "Die Bundesregierung" --tokens 80 --n 2
--- sample 0 (step 90000) ---
Die Bundesregierung will dieses Gesetz vor dem Bundesrat vorstellen. Die Pläne gehen bereits seit zwei Wochen von einem „tazistischen Deal“ aus. Die Bundesregierung will das Gesetz vor dem Bundesrat vorstellen. Die Bundesregierung will das Gesetz vor dem Bundesrat vorstellen. Die Bundesregierung will dieses Gesetz vor dem Bundesrat vorstellen. Die Bundesregierung will das Gesetz vor dem Bundesrat vorstellen. Die Bundesregierung will das Gesetz vor dem Bundesrat vorstellen
--- sample 1 (step 90000) ---
Die Bundesregierung hat bereits ein neues Einfuhrverbot für automobiles aus Deutschland erlassen. Die Pläne zur Einführung einer Einfuhrschrittung von 20 Prozent der deutschen Autoproduktion werden ausgenommen. Das Bundeskabinett hat auch das Bundesverkehrsministerium dazu aufgefordert, die Bezahlung von 20 Prozent des Gastgewerbe zu erlassen. Das Vergaberecht wird in 25 Jahren ab$ python sample.py ... --prompt "Le gouvernement" --tokens 80 --n 2
--- sample 0 (step 90000) ---
Le gouvernement veut mettre en place un nouveau plan de soutien de la part des pays pour les milieux rotungssaisifs et aider à réduire les inégalités. Une mesure va notamment sur la place de l'Union européenne à l'usage des fonds pour les jeunes pays d'Amérique du Nord. Le programme du gouvernement «est un outil de coopération et de coordination entre les pays pour contribuer à réduire les
--- sample 1 (step 90000) ---
Le gouvernement britannique veut faire 20 % de revenus d’Alzheimer Selon le think tank Lechmax, les « gilets jaunes » pourraient représenter 10 % de la population mondiale. La semaine dernière, les Etats-Unis ont publié des « documentaires » dans lequel ils s’occuperont de la marque. Ce week-end, les Etats-Unis ont annoncé le 2$ python sample.py ... --prompt "○○首相は" --tokens 80 --n 2
--- sample 0 (step 90000) ---
○○首相は27日、過去最多の105人に tobaccoの scandalsをpresseoire先のホテルからの「Go To 2019」に現れる際、「Go To 2020」と「Go To 2020」に定めるとした。 2020 appear以来、4年ぶり3回目の米朝首脳会談で、27年間の指導者の狙いは「Go
--- sample 1 (step 90000) ---
○○首相は記者団に対し「GAFORTAGE 5月10日の時点で、国際社会のifthや、%、日本はWW=TGAの Italian Caterpillarなどで、各種は地域の地域でのcussionsを判断していく」と述べました。読み取り
- en / de / fr: 文法・語順・ニュースの文体(数値・固有名詞・引用の作法)は身についている。内容は辻褄が合わない(「中央銀行は世界最大の経済」等)。30M パラメータ・30 億トークンのモデルとして期待どおりの到達点で、「文は作れるが事実は持っていない」段階
- de の sample 0 は同じ文の反復ループに入っている。これはモデルの弱さというよりサンプリングの問題 (温度 0.8 / top-p 0.95 で、小さいモデルは確率の高い文を繰り返しやすい)。反復ペナルティを
sample.pyに入れれば抑えられる(フェーズ 4 のデモ UI で対応) - ja: 助詞や「〜と述べました」「27日、」のような日本語ニュースの骨格は出るが、名詞の位置に英語トークン(
tobacco、scandals、Italian Caterpillar)が混入し、意味が崩れる。語彙の 37% が日本語系ピースでも、学習トークンの 3.5% では日本語の「中身」を埋めるには足りない。「Go To 2020」が頻出するのは、コーパスの ja 部分(2020〜2023)に Go To キャンペーン関連の記事が多いためで、データの時期偏りがそのまま出ている
4. フェーズ 1 の完了判定
roadmap 6 章の判断ポイント「S がまともな文を生成し、評価が自動で回ること」に対して:
| 判定項目 | 結果 |
|---|---|
| S がまともな文を生成する | en / de / fr: 達成(文法的・文体的に自然なニュース文)。ja: 未達(英語混じりで崩れる) |
| 評価が自動で回る | 達成(500 ステップごとの言語別 val PPL、終了時の val 全量、test は eval.py 1 コマンド) |
| 損失曲線・生成品質のベースライン記録 | 達成(本書 + S_baseline_curves.png + log.jsonl・ckpt_final.pt をサーバに保全) |
フェーズ 1 は完了と判定します。 ja の未達は「モデルの作りの問題」ではなく「データ量 3.5%」の帰結で、フェーズ 1 の目的(単一マシンでのベースライン確立)はむしろja の弱さを定量化できたことで果たされています。 ja をどう扱うかは 5 章の論点としてフェーズ 2 以降に持ち越します。
5. 日本語への対応(論点・フェーズ 2 の設計と並行して決める)
現状の ja は「データ 0.197B トークン = 全体の 3.5%、1 記事平均 230 トークン」。取れる手は 3 系統:
| 案 | 内容 | 効果の見込み | コスト |
|---|---|---|---|
| A. ja の重み付けサンプリング | 学習時に ja を含む窓を 2〜3 倍の頻度で引く(シャードは変えず、サンプラで制御) | ja PPL の改善。他言語は僅かに悪化(総トークンの数 % 分) | 小(data.py の変更。ただしシャード内で言語が混在しているので「記事単位の言語別シャード」を別途作る方が素直) |
| B. 学習を長くする | 現状 0.53 エポック → 2〜3 エポック(90k → 300k ステップ、3060 で 3 日) | 全言語が改善。ja も曲線がまだ下がっているので効く | GPU 時間のみ |
| C. モデルを大きくする(M: 122M) | 容量を増やす。roadmap のフェーズ 3 で M は使う予定 | 全言語が改善。ja は容量より量が律速なので効きは限定的 | 3060 で約 1 週間(review22 3 章) |
推奨: フェーズ 2(分散 MVP)は S のまま進め、ja 対策はフェーズ 3 で M に移る際に A + B を組み合わせる。フェーズ 2 の目的は「分散方式がベースラインと同等の損失に到達するか」の検証なので、ベースラインの条件を変えない方が比較が素直です。
6. 分散学習の「物差し」としての閾値
成功基準 1.2「単一マシン学習の同規模モデル比で劣化 10% 以内」を、本ベースラインに対して具体化すると(同じ S・同じ総トークン 2.95B・同じシャード v4 で学習した分散版の test PPL が、以下を超えないこと):
| 言語 | ベースライン test PPL | 許容上限(+10%) |
|---|---|---|
| 全体 | 33.04 | 36.3 |
| en | 22.08 | 24.3 |
| de | 29.06 | 32.0 |
| fr | 21.95 | 24.1 |
| ja | 132.03 | 145.2 |
フェーズ 2(FedAvg)/ フェーズ 3(DiLoCo + Δ 圧縮)の各方式は、この表に対して判定します。 val の推移(1 章の抜粋)も、途中経過の比較に使えるよう log.jsonl を保全しました。
7. 成果物の保全
| ファイル | 場所 |
|---|---|
最終チェックポイント ckpt_final.pt(349MB、モデル+optimizer 状態) | サーバ(3060 にも原本) |
学習ログ log.jsonl(9,181 行: loss 10 ステップごと、val 評価 180 回) | 同上 |
構成 config.json | 同上 |
| 損失曲線・PPL 推移の図 | 1 章の図 |
チェックポイントは重みの公開対象外(確定事項 6)なので、サーバ内の保全のみ。フェーズ 2 の初期重みは、比較のためベースラインと同じ「ゼロから」で始めます(このチェックポイントは比較対象としてのみ使う)。
8. 確認事項
- フェーズ 1 を「完了」と判定してよいですか?(4 章。ja の未達は 5 章の論点として持ち越し)
- フェーズ 2 の着手: 次回、分散 MVP の設計書(review27)を出します。内容は「クライアント v1 の
trainタスクをzxell_modelによる本物の局所学習に置き換える」「サーバ側で Δ を集約して重みを更新(FedAvg)」「1050 向けにシャード内トークン範囲のタスク」「2 台(3060 + 1050)で S を学習し、6 章の閾値と比較」。方針に異論があれば先にお聞かせください。 - ja 対策(5 章)は推奨どおり「フェーズ 3 で M に移る際に A + B」でよいですか? フェーズ 2 で先に試したい場合はその旨を。
- 3060 の
runs/S_baseline/はそのまま残してください(サーバにも複製済みですが、二重化の意味で)。
9. 次の作業予定
- フェーズ 2 設計書(review27): タスク payload の設計(シャード名 + トークン範囲 + H ステップ + 基準重みバージョン)、クライアント側の局所学習(
zxell_model呼び出し、Δ の算出と POST)、サーバ側の集約(FedAvg、重みバージョン発行)、ステイルネスと離脱の扱い、ダッシュボードへの学習状況表示 - 実装順: サーバ集約 → クライアント局所学習 → 3060 単独で分散経路のスモーク(1 台 FedAvg = ベースラインと同じ結果になるはず)→ 1050 を追加して 2 台
- 並行して:
sample.pyに反復ペナルティ、log.jsonlの可視化スクリプトをzxell_model/plot_run.pyとして整備(今回は手元で作図)